Evaluation de cas cliniques complexes
Développer un outil pour évaluer des réponses ouvertes à des cas cliniques complexes
Pour savoir si un système d'IA suit les recommandations de la SFAR, il faut pouvoir noter ses réponses. Dans le benchmark antibioprophylaxie, le modèle doit répondre par un seul mot, par exemple un nom de molécule, ce qui permet une correction déterministe, reproductible et peu coûteuse. Pour des vignettes cliniques plus complexes cependant, comme celles sur la gestion des anticoagulants, où l'on attend comme réponse un raisonnement rédigé, il est nécessaire d'utiliser des outils capables de traiter le langage et de juger.
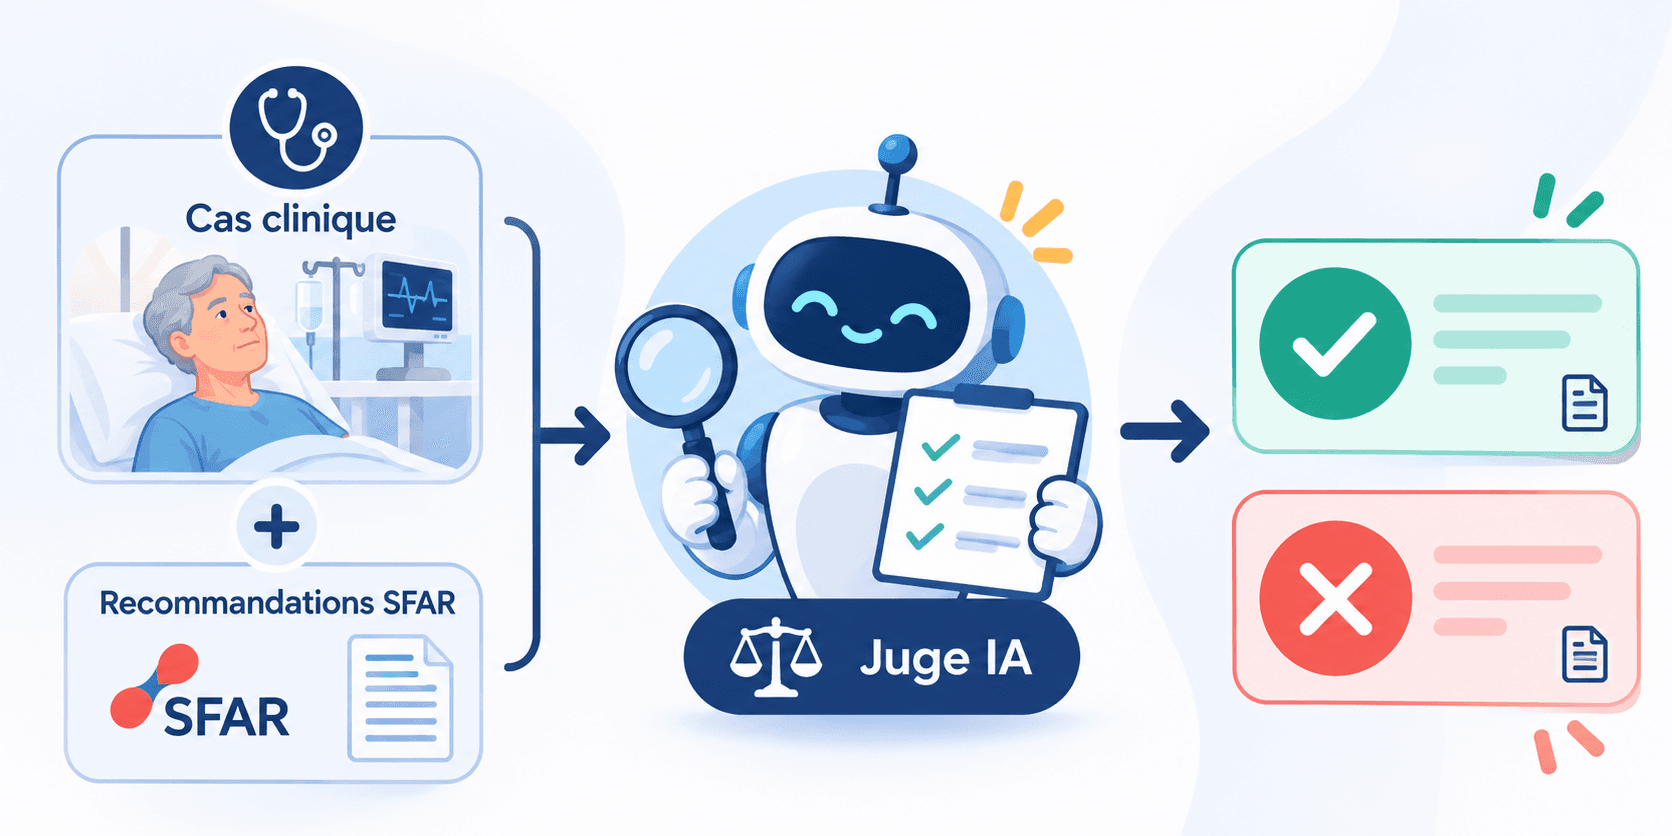
Pour ces vignettes, une solution envisageable est d'utiliser un modèle de langage comme juge (LLM as a judge), qui permettrait de vérifier la concordance avec les recommandations. Les recommandations ne couvrent pas tout : une bonne réponse peut aussi s'appuyer sur des articles de recherche, et il faut savoir juger si elle le fait à bon escient.
Les documents fournis pour le datathon disposent par ailleurs de métadonnées (thématique, date, type de document, etc.) qui peuvent aider le juge à retrouver la bonne recommandation et à expliquer sa note. L'enjeu est de construire un juge fiable, reproductible et peu coûteux.
Ce que nous allons produire
L'objectif est de développer un juge capable de comparer la réponse d'un système d'IA à une vignette avec les recommandations de la SFAR, et d'indiquer si elle est concordante ou non, en justifiant sa note. Pour cela, nous produirons :
- un dataset de vignettes complexes avec leurs recommandations associées, découpées en énoncés atomiques ;
- un enrichissement de ce dataset avec des sources autres que les recommandations, comme les articles de recherche ;
- une utilisation des métadonnées pour citer les passages des recommandations applicables et rendre la note plus explicable ;
- une évaluation du modèle juge sur ce dataset, en comparant ses notes à celles données par des médecins.
Ce travail s'inscrit dans le projet de plateforme d'évaluation : l'objectif est qu'elle puisse noter des réponses ouvertes complexes en plus des réponses courtes. Le dataset ainsi produit pourra également servir à évaluer les outils de RAG sur des vignettes complexes en validant que les documents remontés sont bien ceux que les médecins ont associés aux vignettes.
Le code et les consignes du juge seront publiés en open source afin de rendre les résultats reproductibles et de permettre à d'autres équipes de réutiliser le travail.
Qui peut contribuer ?
- Des scientifiques, développeur.euses et ingénieur.es de la donnée, pour concevoir le juge, l'appliquer aux réponses de différents systèmes et mesurer sa fiabilité sur la plateforme LibreDataHub.
- Des médecins, pour construire et valider les vignettes du dataset ainsi que pour évaluer les réponses de LLM sur ces vignettes, afin de donner un référentiel aux notes du modèle juge.
Déroulé
- Jour 1 : choix et développement des vignettes, définition de la grille de notation avec les médecins et mise en place d'une première version du juge.
- Jour 2 : comparaison du juge avec les notes des médecins, travail sur les sources externes et les métadonnées, restitution collective.
Données utilisées
Les recommandations de la SFAR et leurs métadonnées, les articles de recherche fournis pour le datathon, des vignettes cliniques (notamment sur la gestion des anticoagulants) et les réponses produites par différents systèmes d'IA.
Aucune donnée de patient.